
Классический план звучит уверенно: «добавим чат-бота». Через месяц виджет в углу открывают единицы. Ещё через месяц про него забывают даже в отчётах.
Проблема не в модели. Проблема в том, что человека притащили в отдельное окно, хотя он пришёл за товарами.
Другая механика
Ассистент встроен в витрину. Запрос обычным языком — и каталог перестраивается. Не «вот вам текст», а «вот вам карточки» плюс короткое объяснение у каждой.
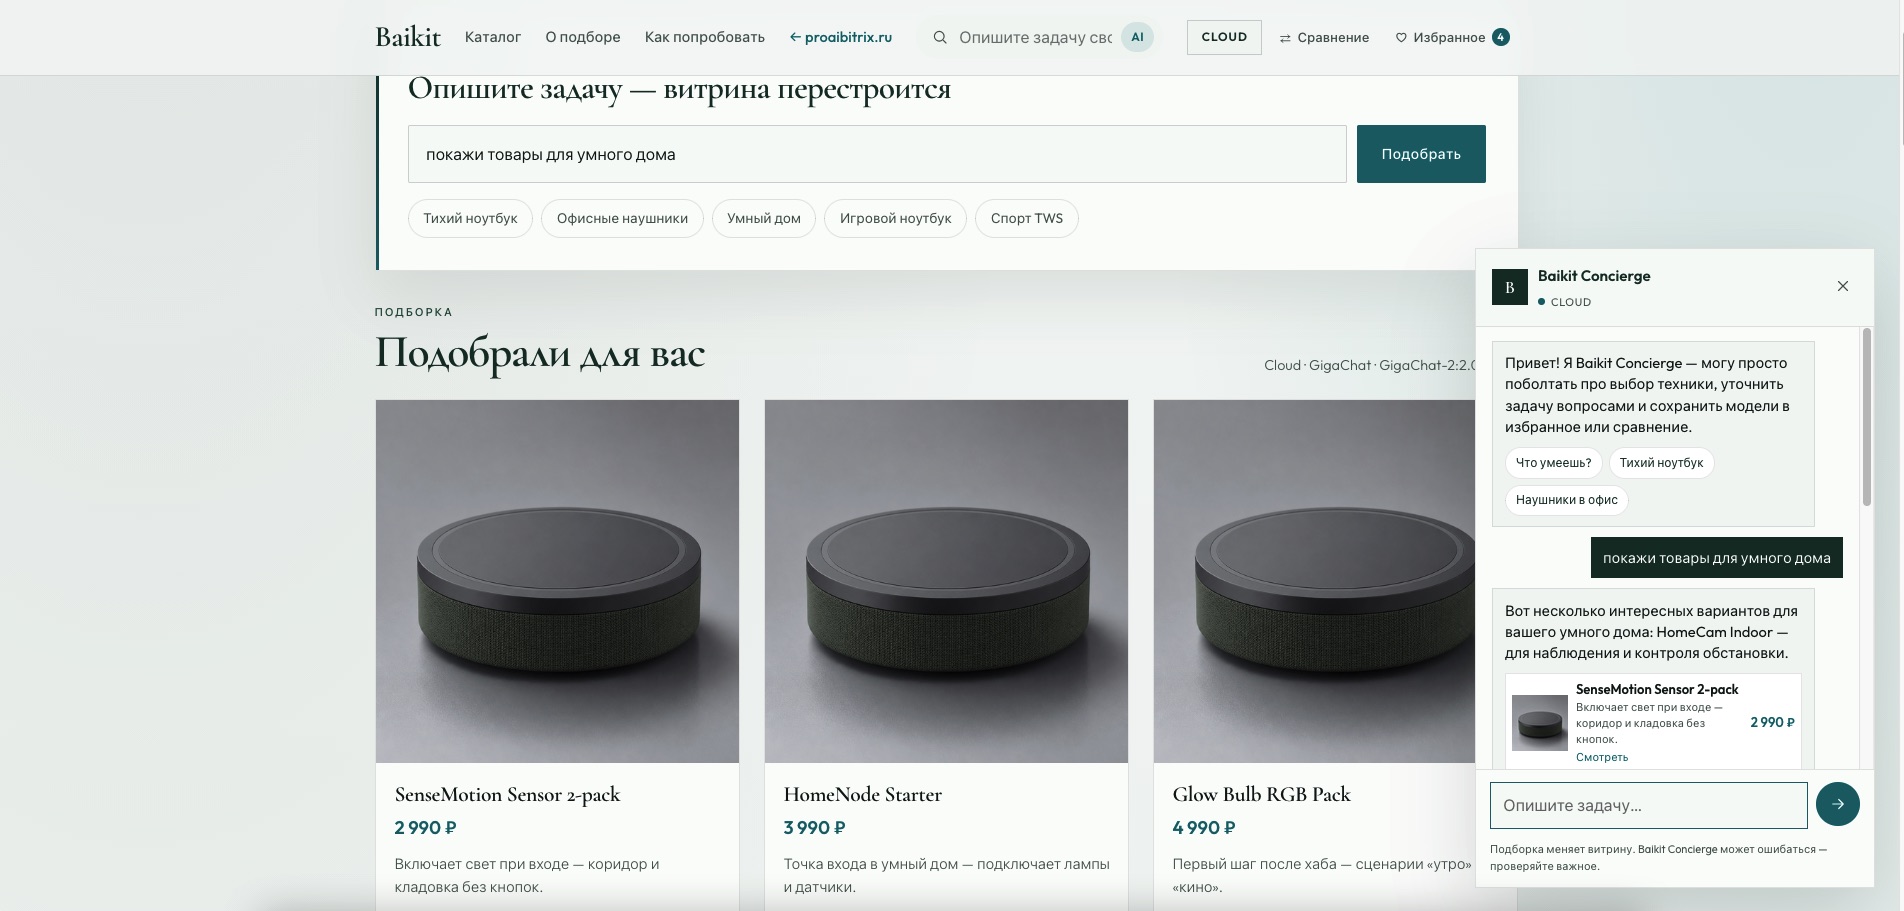
Что это меняет на практике
- Нулевой порог: человек остаётся в привычном каталоге.
- Результат измерим: клики по карточкам и добавления в корзину после запроса.
- Чат можно оставить — но как уточнение, а не как главный канал.
Три грабли, на которые лучше не наступать
Весь каталог в промпт. На сотне SKU прокатит. На десятках тысяч — нет. Сначала shortlist, потом модель.
Ассистент, прибитый гвоздями к одному каталогу. Нужен тонкий слой между LLM и товарами — у меня это CatalogPort: сменился каталог, UX и API остались.
Только облако. Бывает, данные нельзя отдавать наружу. Локальный fallback (Ollama) спасает и нервы, и договор.
// Плохо: надеяться, что модель «сама найдёт» среди 30k SKU
// $llm->ask($query, $entireCatalog);

// Лучше: сузить, объяснить, отдать витрине
$shortlist = $search->find($query, 24);
$items = $llm->explain($query, $shortlist);
foreach ($items as $item) {
    // $item['sku'], $item['why']
}
Живой разбор этого подхода — в кейсе AI-ассистента для Битрикс.